
 热点资讯
闪迪新专利: 将NAND闪存堆叠在计算芯片下方, 破解存储瓶颈
IT之家6月22日消息,闪迪正在研发更多创新方案以解决存储容量受限问题,例如在芯片内部堆叠NAND闪存。
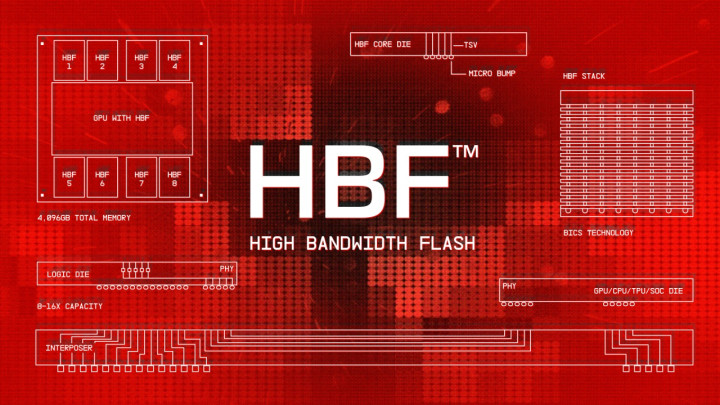
IT之家注意到,人工智能行业飞速发展,算力需求同步激增,各类性能瓶颈随之暴露,这倒逼DRAM与NAND闪存厂商跳出固有思维、探索突破性技术路线。
过去,芯片厂商只需推出全新存储技术就能满足需求,彼时DRAM是核心存储器件。但如今研发成本攀升、工艺良率存在短板、芯片功耗持续走高,行业不得不转向其他可行技术方案。高带宽内存(HBM)此前一直稳步迭代,可受产能短缺影响,其自身也迅速演变为新的性能瓶颈。
HBM还存在其他短板,单堆叠容量偏低。尽管各代DRAM厂商持续提升HBM的带宽与单堆容量,产能供给始终跟不上市场需求。同时HBM仅能放置在主芯片侧边,芯片间数据传输存在显著延迟损耗。
再看NAND闪存,它单位存储成本更低、单盘容量更大,但存储介质距离主计算芯片更远,数据传输速度更慢,始终无法达到DRAM(HBM)同级别的读写带宽。
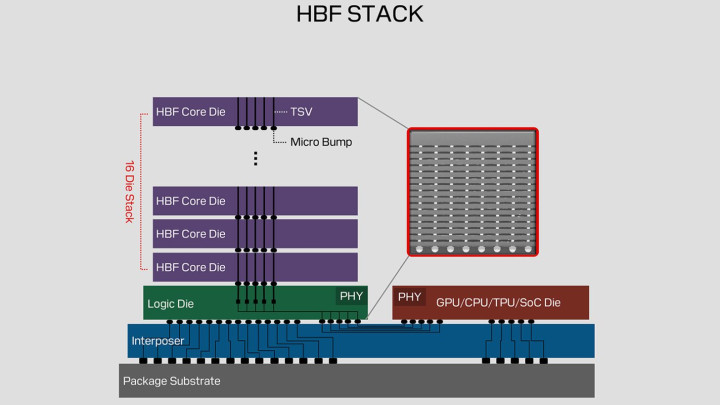
为破解上述难题,闪存厂商闪迪此前公布了自家高带宽闪存(HBF)技术方案。据悉HBF采用与HBM相似的分层架构:将多层NAND闪存垂直堆叠,各层通过大量硅通孔(TSV)互连,把多组NAND闪存封装整合为单一堆叠单元。目前单组HBM堆叠容量仅32~64GB,而HBF单堆容量最高可拓展至4TB。
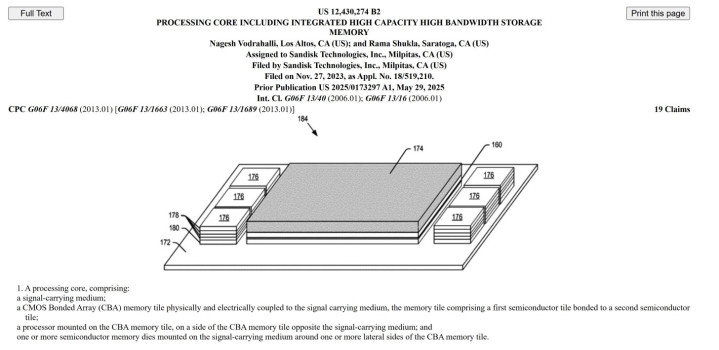
该方案虽解决了容量与带宽痛点,但人工智能、高性能计算(HPC)的远期算力需求仍需要更前沿的技术支撑,闪迪最新专利(专利号US12,430,274B2)正是为此而生。该专利提出一种3D堆叠架构:将搭载CMOS键合阵列(CBA)的NAND闪存存储裸片堆叠在主计算裸片下方,主计算裸片可为AI加速器或图形处理器(GPU)。该架构仍在同一中介层搭载HBMDRAM,但二者分工截然不同。
这套架构可谓一举两得:HBM负责处理低延迟、高优先级的即时读写任务;而存储裸片上的NAND闪存承担大容量数据读写操作。NAND闪存裸片与计算芯片之间采用宽通道互联,能够同时降低传输延迟、硬件成本与整体功耗。
一个完整计算核心由多核处理器与高带宽、大容量非易失性存储直连集成构成;处理器可以是高性能图形处理器(GPU)或人工智能处理器。非易失性存储由CMOS键合阵列(CBA)存储裸片组成,该裸片整合单片大容量NAND存储层与CMOS逻辑电路层。集成后的处理器与CBA存储裸片共同固定在中介层之上。计算核心还可在处理器与CBA存储裸片的单侧或多侧周边,于中介层上搭载多组高带宽内存(HBM)半导体堆叠裸片。
尽管这项专利技术为我们勾勒出一套能够彻底破除存储瓶颈的未来硬件架构,但需要明确:该方案目前仅停留在专利阶段。想要落地量产,仍需攻克诸多难题,例如整机功耗控制、单封装同时集成NAND与DRAM带来的制造成本等一系列工程问题。
这份专利为“计算芯片堆叠NAND闪存”架构构建了壁垒极高、经过完整论证的技术护城河,尤其是裸片间宽通道互联、跨裸片布线方案,行业很难复刻。不过当前行业内走向标准化的成熟产品,采用的仍是技术门槛更低、已实现商用的“侧边并置”方案。后续最值得关注的行业走向尚未明朗:闪迪最终能否打通专利保护的前沿架构与当前在售量产产品之间的技术鸿沟。对外发布的技术方案只是表面新闻,这份专利才是闪迪深层的长期战略蓝图。